RobustAI-Drift
Robustesse des modèles d'apprentissage profond face à la dérive des données
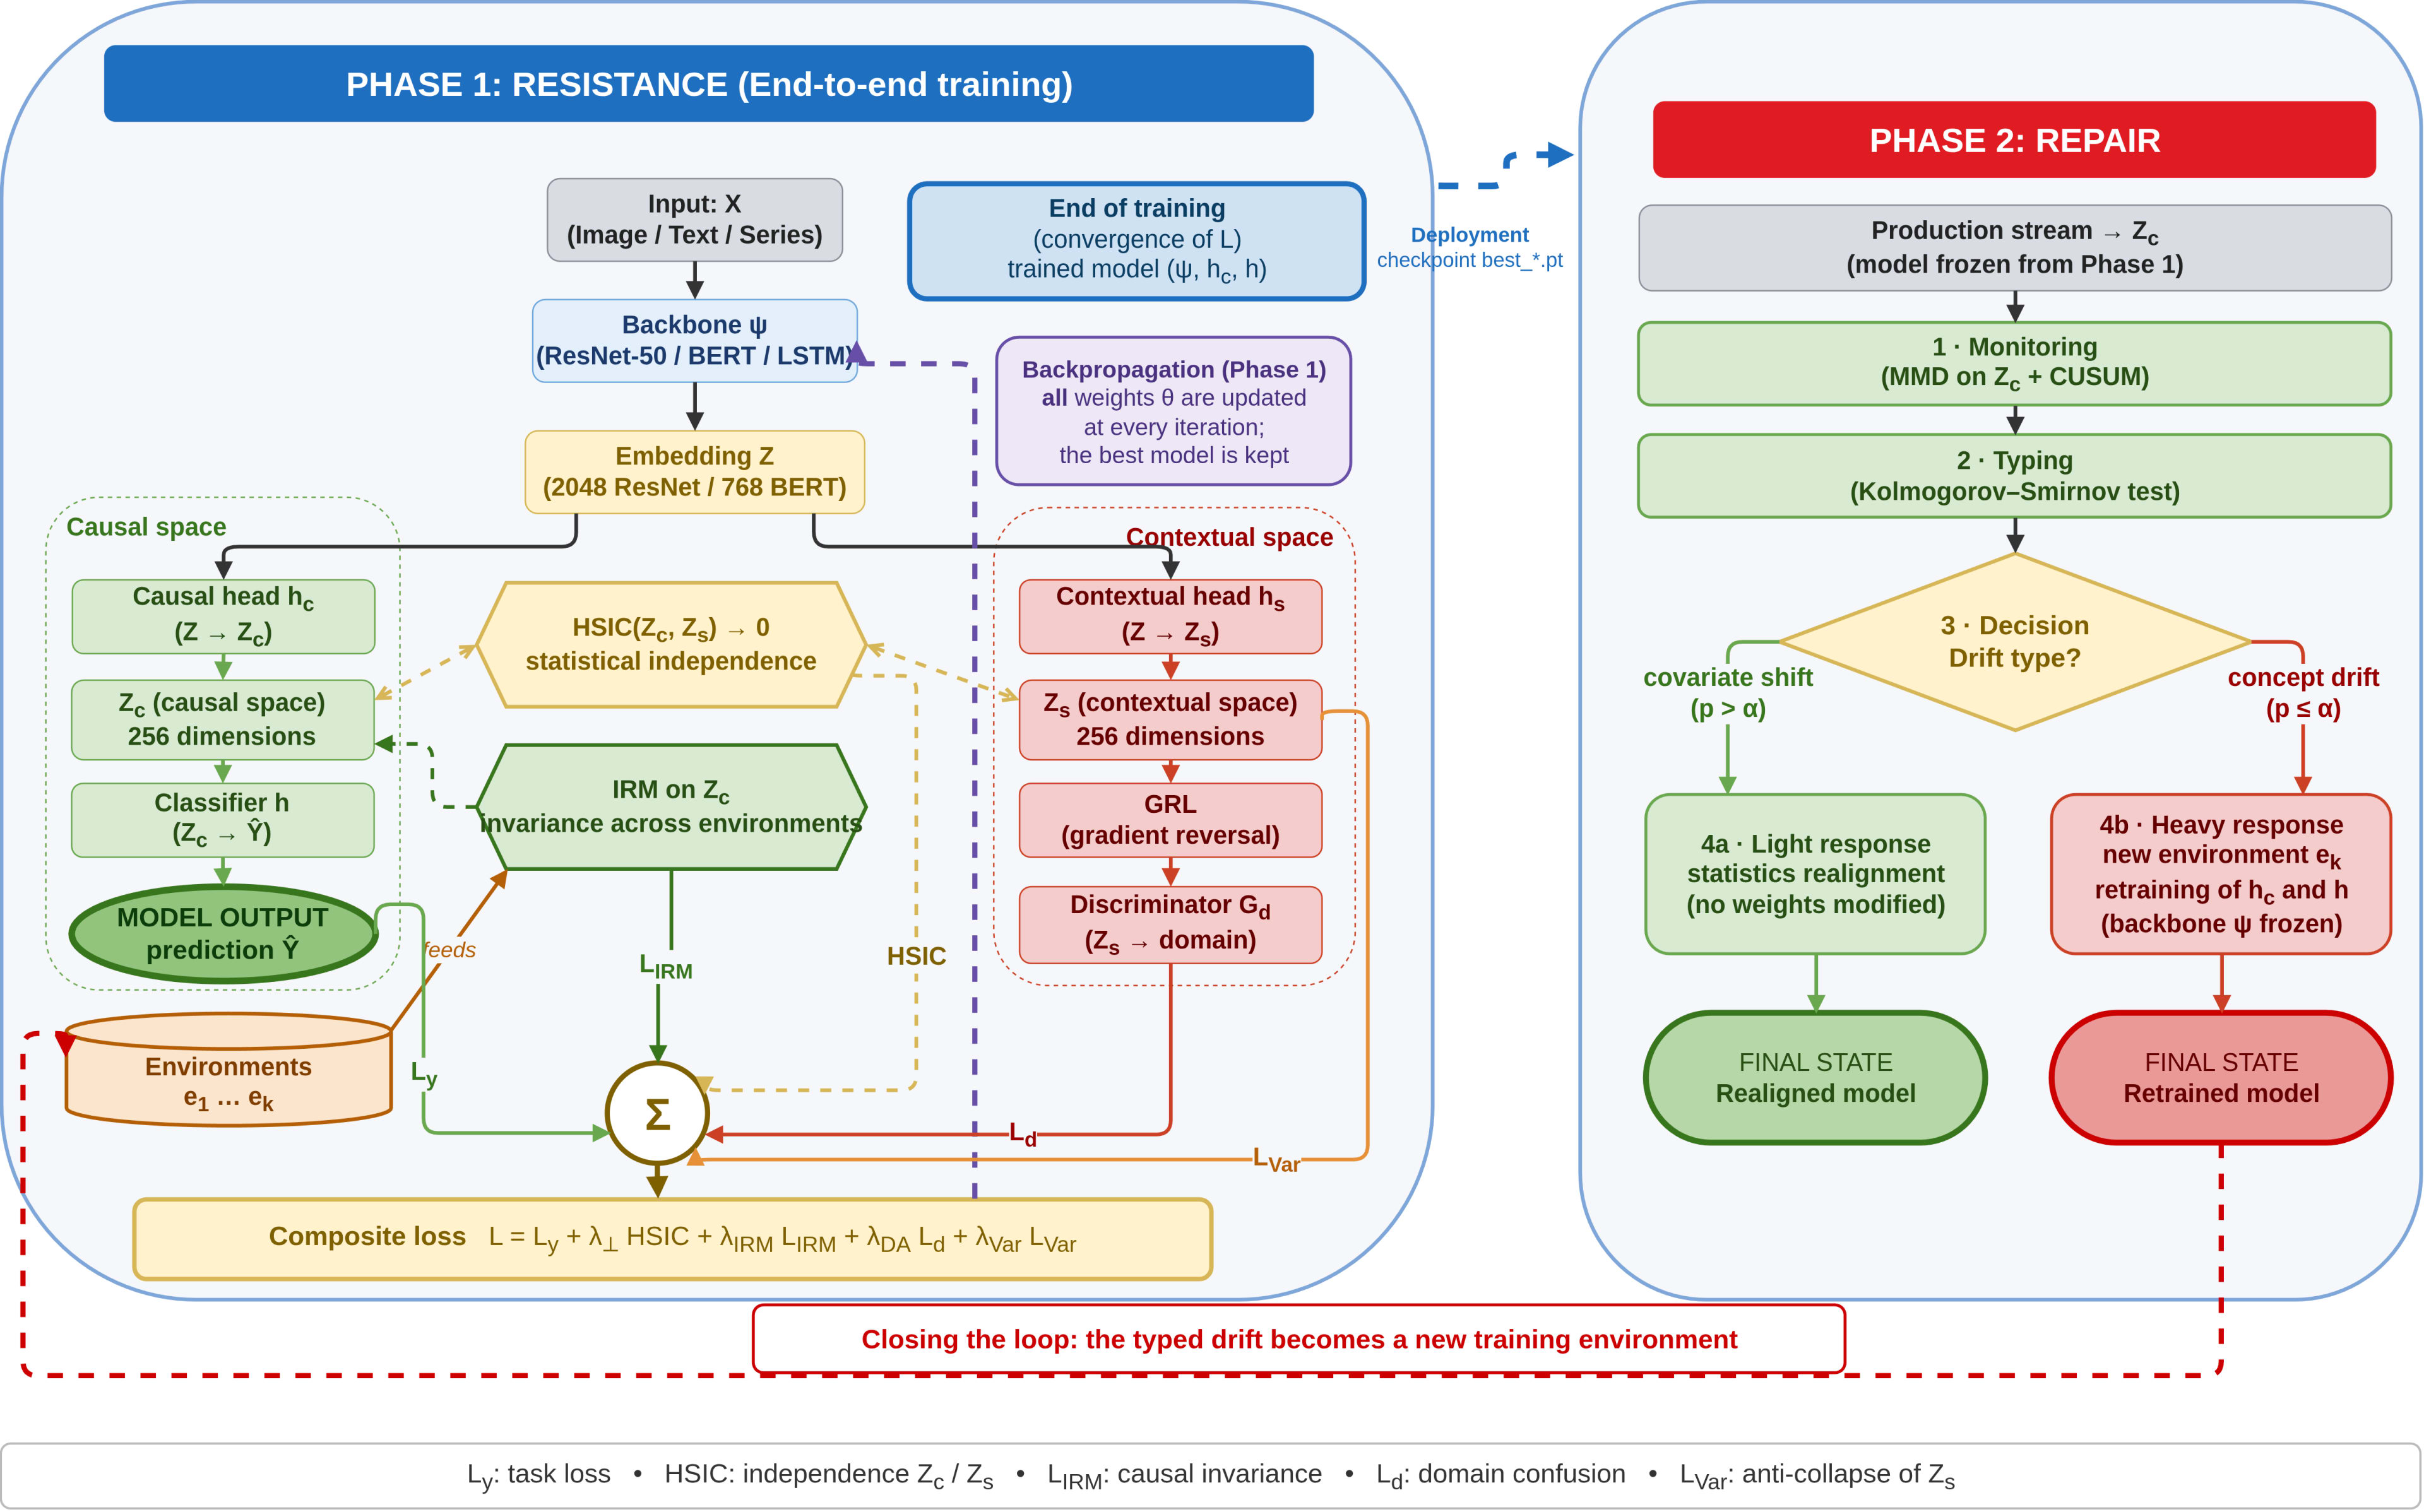
Mémoire de Master recherche en informatique. RobustAI-Drift est une architecture hybride « résistance–réparation » qui rend les modèles d'apprentissage profond plus robustes quand les données de production s'écartent des données d'entraînement. Elle réunit dans un seul système trois approches que la littérature traite séparément : la séparation causale des représentations, l'invariance entre environnements et la détection suivie de la réparation de la dérive en production.
Outils utilisés
- Python
- PyTorch
- scikit-learn
- NumPy
- SciPy
- pandas
- Matplotlib
- Weights & Biases
- pytest
- Google Colab
Le défi
Les modèles d'apprentissage profond supposent que les données d'entraînement et de déploiement suivent la même distribution. En pratique, les données dérivent (covariate shift, concept drift) et les performances s'effondrent, sans mécanisme pour détecter la dérive ni s'y adapter. Les méthodes existantes ne traitent qu'une partie du problème : l'adaptation de domaine ignore la causalité, la régularisation causale exige des environnements définis à la main, et la détection de dérive ne répare rien.
La solution
Phase 1, résistance (entraînement) : un encodeur sépare la représentation en un sous-espace causal et un sous-espace contextuel, sous une perte composite à cinq termes (classification, contrainte d'indépendance HSIC, neutralisation adverse du contexte par inversion de gradient, pénalité IRM à coefficient adaptatif, terme anti-effondrement).
Phase 2, réparation (production) : un détecteur à trois étages (MMD, puis CUSUM, puis test de Kolmogorov-Smirnov) identifie le type de dérive et déclenche la réponse adaptée : réalignement léger pour un covariate shift, réentraînement ciblé de la tête causale pour un concept drift. La dérive détectée devient un nouvel environnement d'entraînement, ce qui referme la boucle.
Encadrement
Mémoire de Master recherche à l'URIFIA (Université de Dschang), sous la direction du Dr Talla Tankam Narcisse, avec le co-encadrement du Dr Kamdem Igor.
Les données
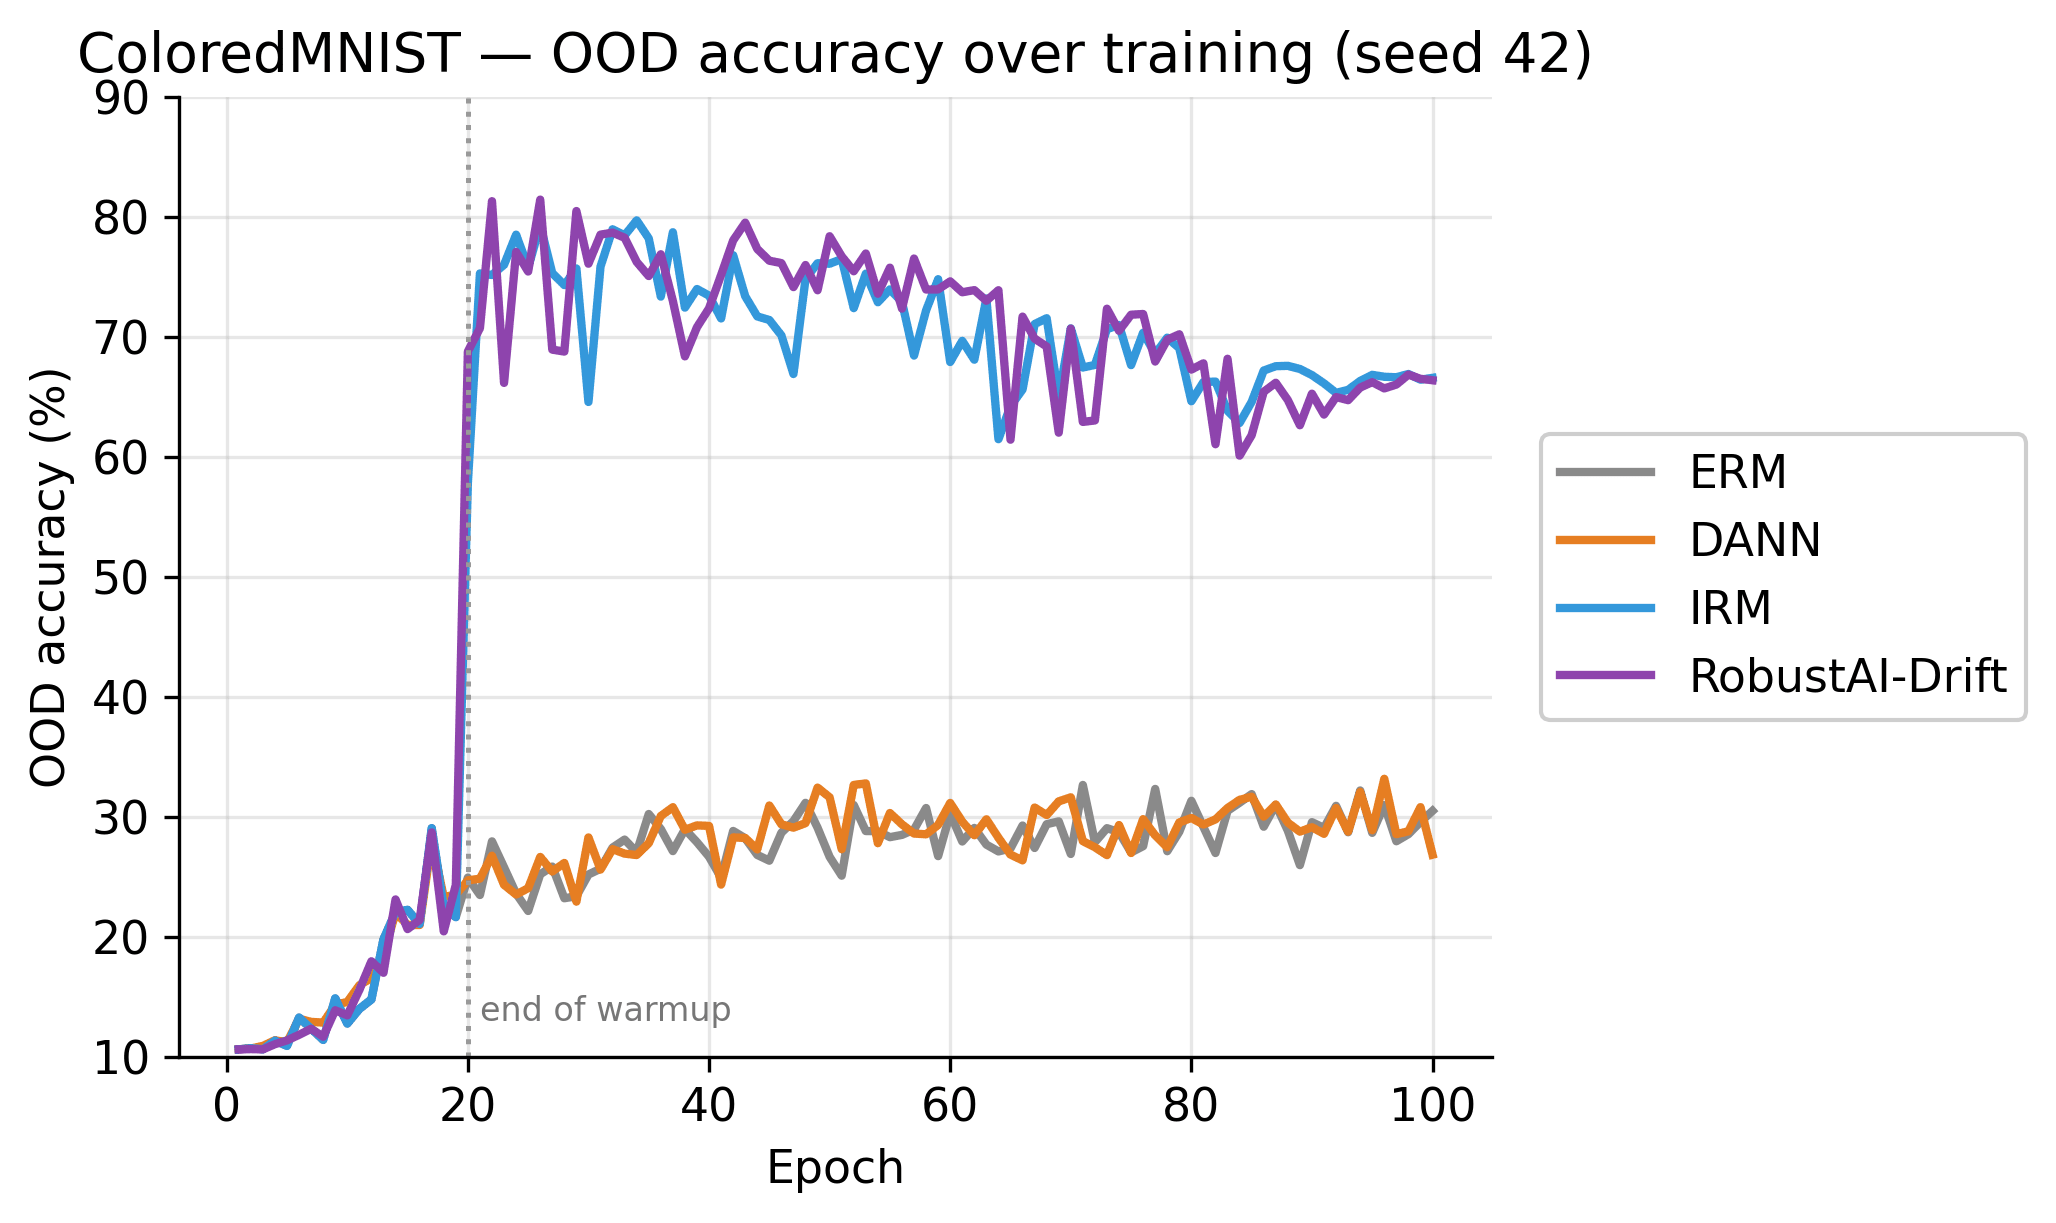
ColoredMNIST : chiffres manuscrits colorés, en classification binaire. La couleur est corrélée à l'étiquette, mais cette corrélation s'inverse au test : le modèle doit apprendre la forme du chiffre, pas sa couleur. Deux environnements d'entraînement de 30 000 images (corrélation de 90 % et de 80 %), un environnement de test de 10 000 images où la corrélation est inversée (10 %), et 25 % d'étiquettes volontairement bruitées.
PACS : 9 991 images, 7 classes et 4 domaines visuels (photo, peinture, dessin animé, croquis). Entraînement sur 3 domaines, test sur le 4ᵉ jamais vu, pour chacun des 4 domaines. Images en 224 × 224 avec augmentation de données.
Le protocole
Un réseau MLP pour ColoredMNIST, un ResNet-50 préentraîné sur ImageNet pour PACS ; 100 époques, optimiseur Adam, pénalité IRM activée après une période de préchauffage. Aucun hyperparamètre n'a été réglé sur l'environnement de test, comme l'exige le protocole DomainBed.
Comparaison avec ERM, DANN et IRM seul. La mesure retenue est le plateau (moyenne des 10 dernières époques), la robustesse réellement exploitable en production. La détection de dérive est évaluée sur trois scénarios : dérive synthétique contrôlée, bruit ajouté aux images et inversion partielle de la corrélation couleur.
Les résultats
Résultats rapportés dans un article en cours d'évaluation dans la revue Pattern Recognition.
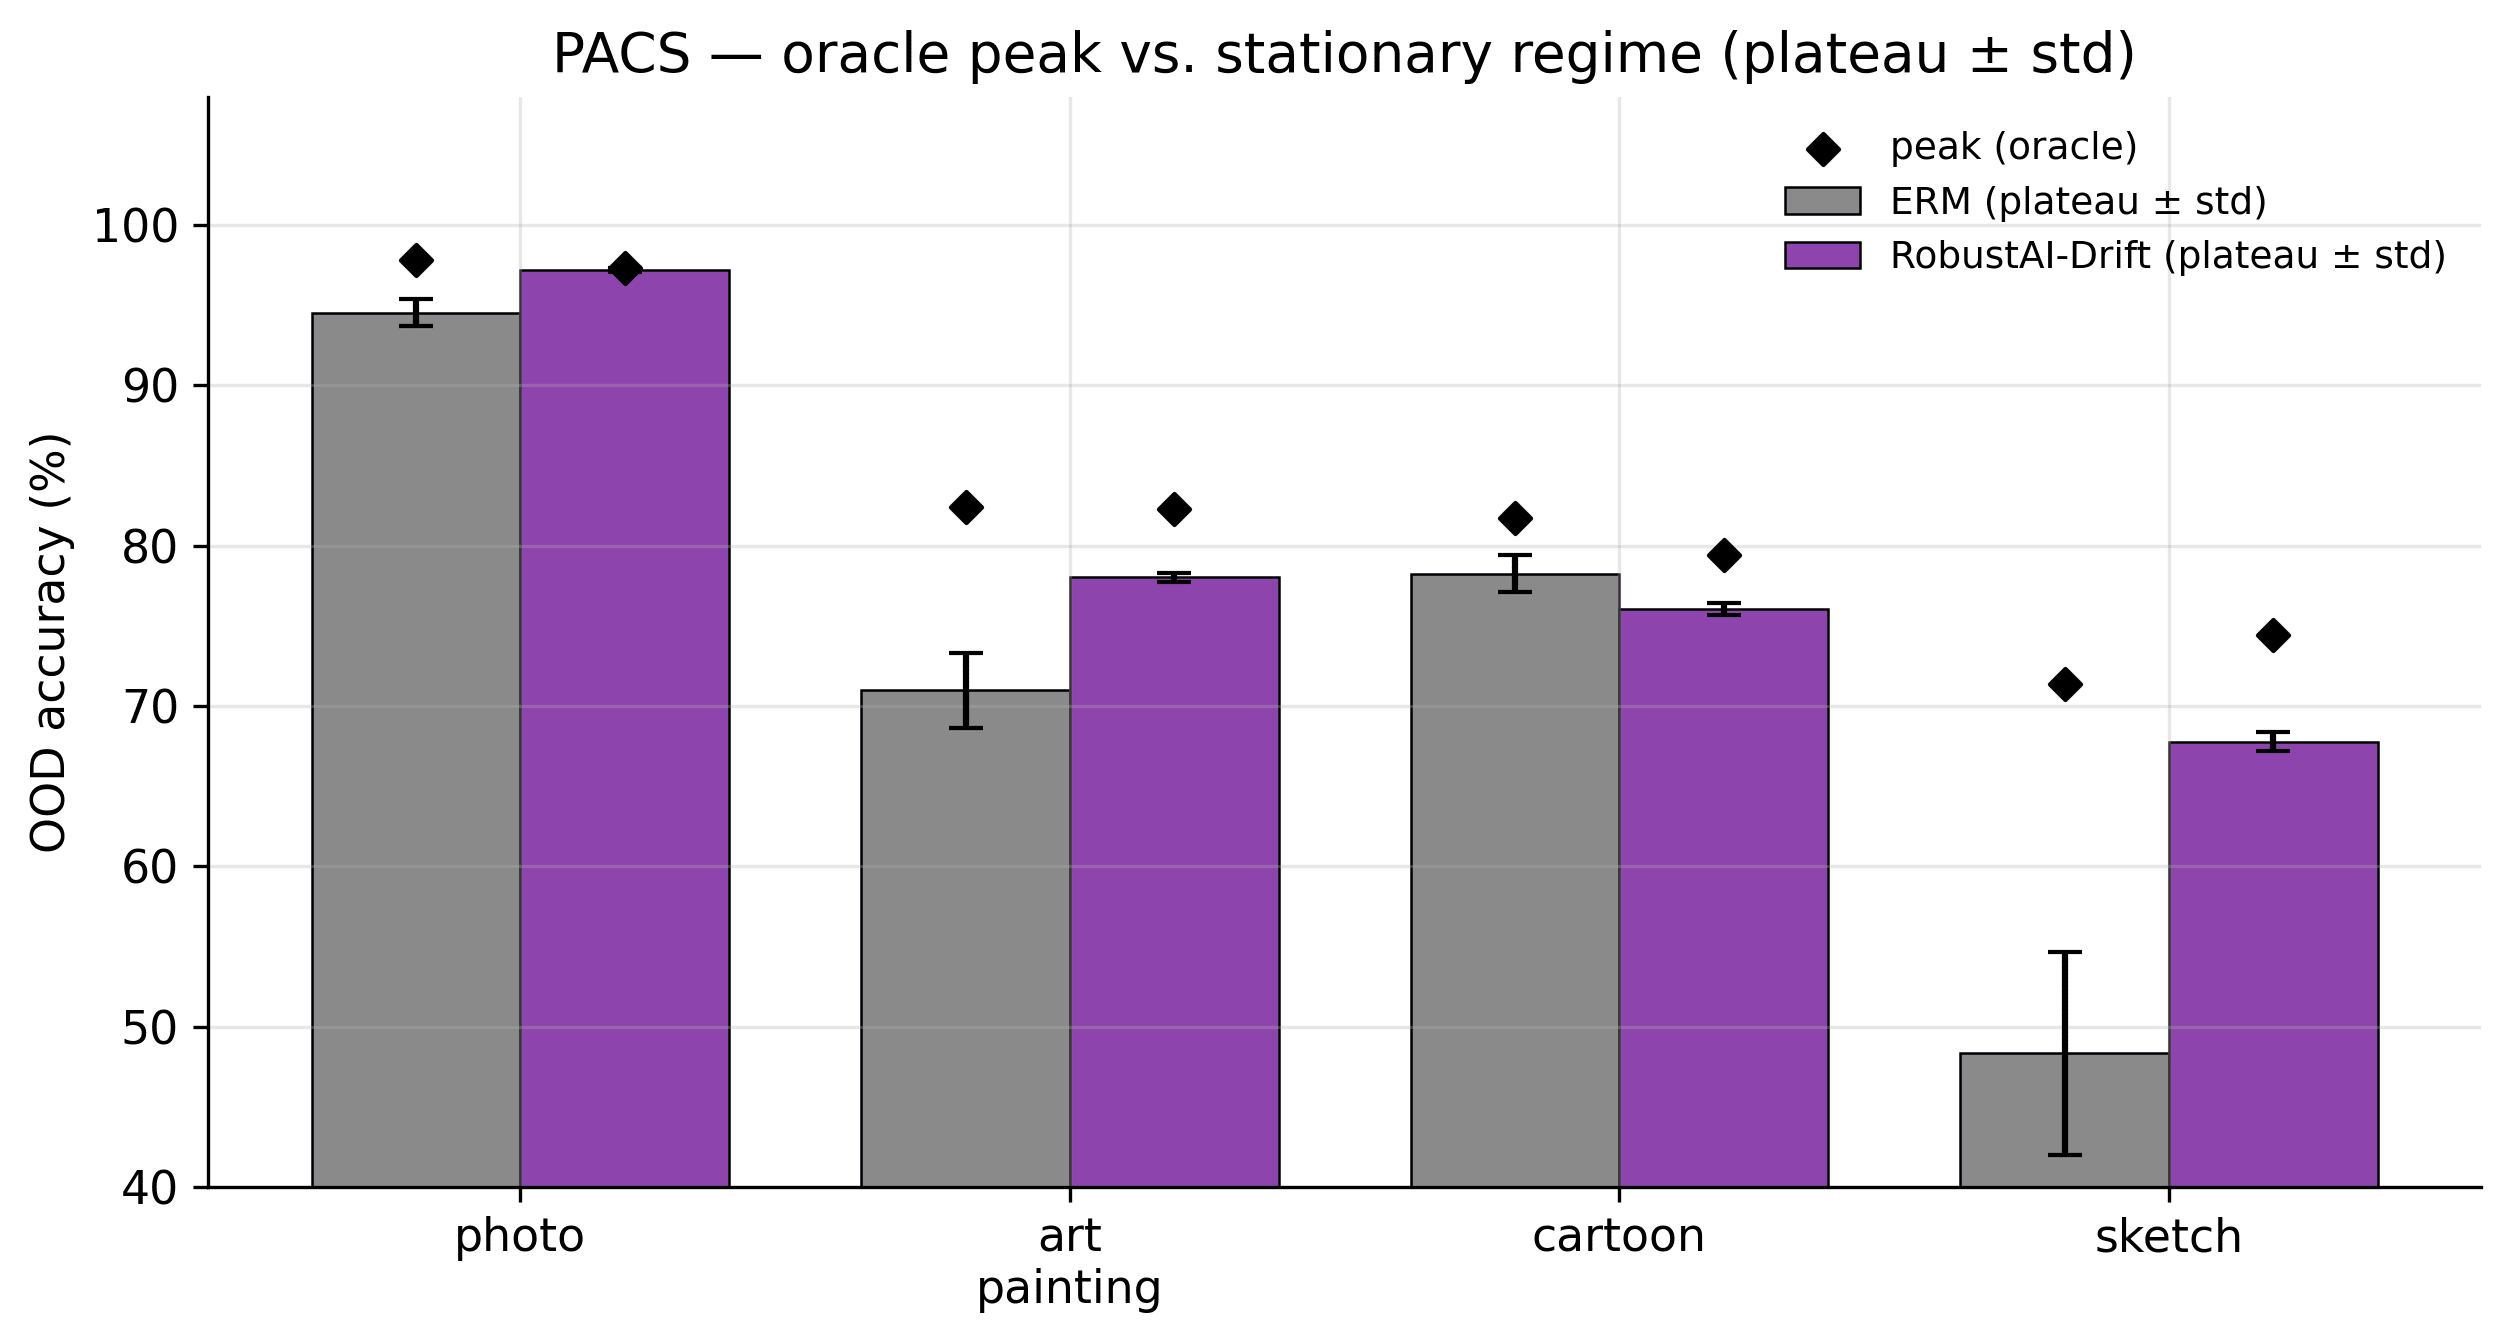
Précision hors distribution de 81,5 % sur ColoredMNIST, contre 32,7 % pour la référence ERM et 80,7 % pour IRM seul. Sur PACS, 79,8 % contre 73,0 % pour ERM, avec une variance nettement réduite : sur les croquis, le domaine le plus difficile, la précision passe de 48,3 % à 67,8 % et l'écart-type de 6,4 à 0,6 point.
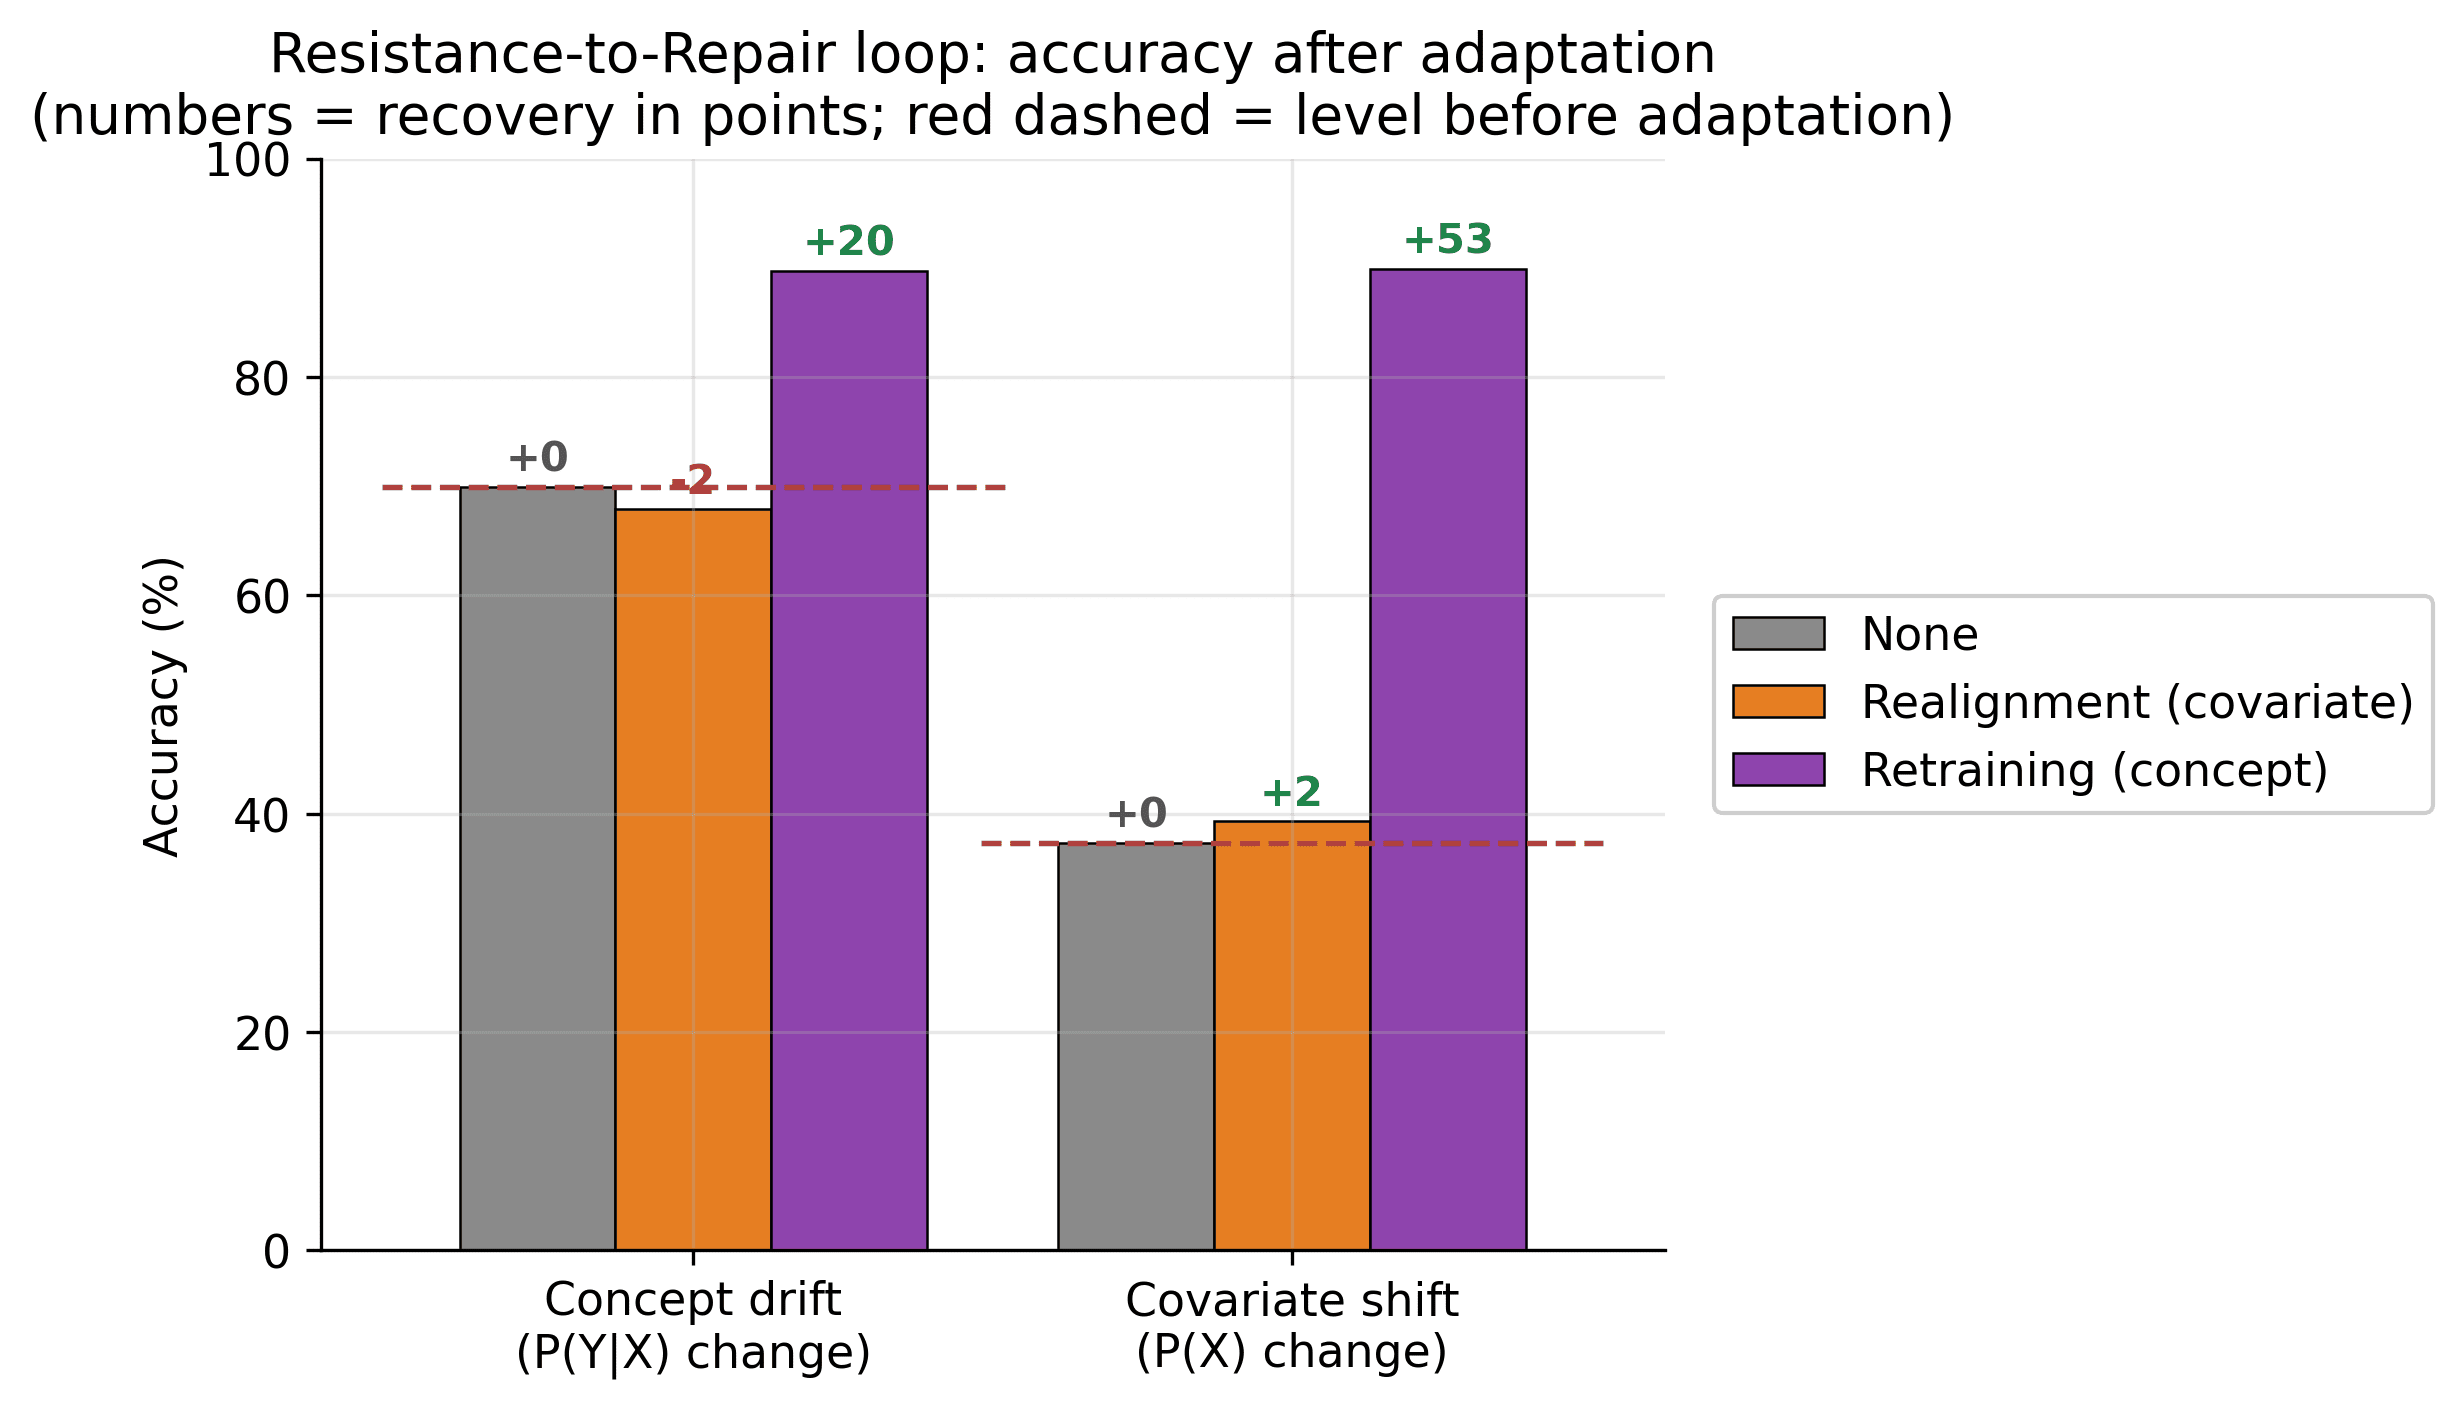
Détecteur de dérive : score F1 de 1,0 en régime contrôlé. Boucle de réparation : après un concept drift, la précision remonte de 69,9 % à 89,7 % ; après un covariate shift, de 37,3 % à 89,9 %. Une réponse mal choisie échoue, ce qui montre que le typage de la dérive est nécessaire.
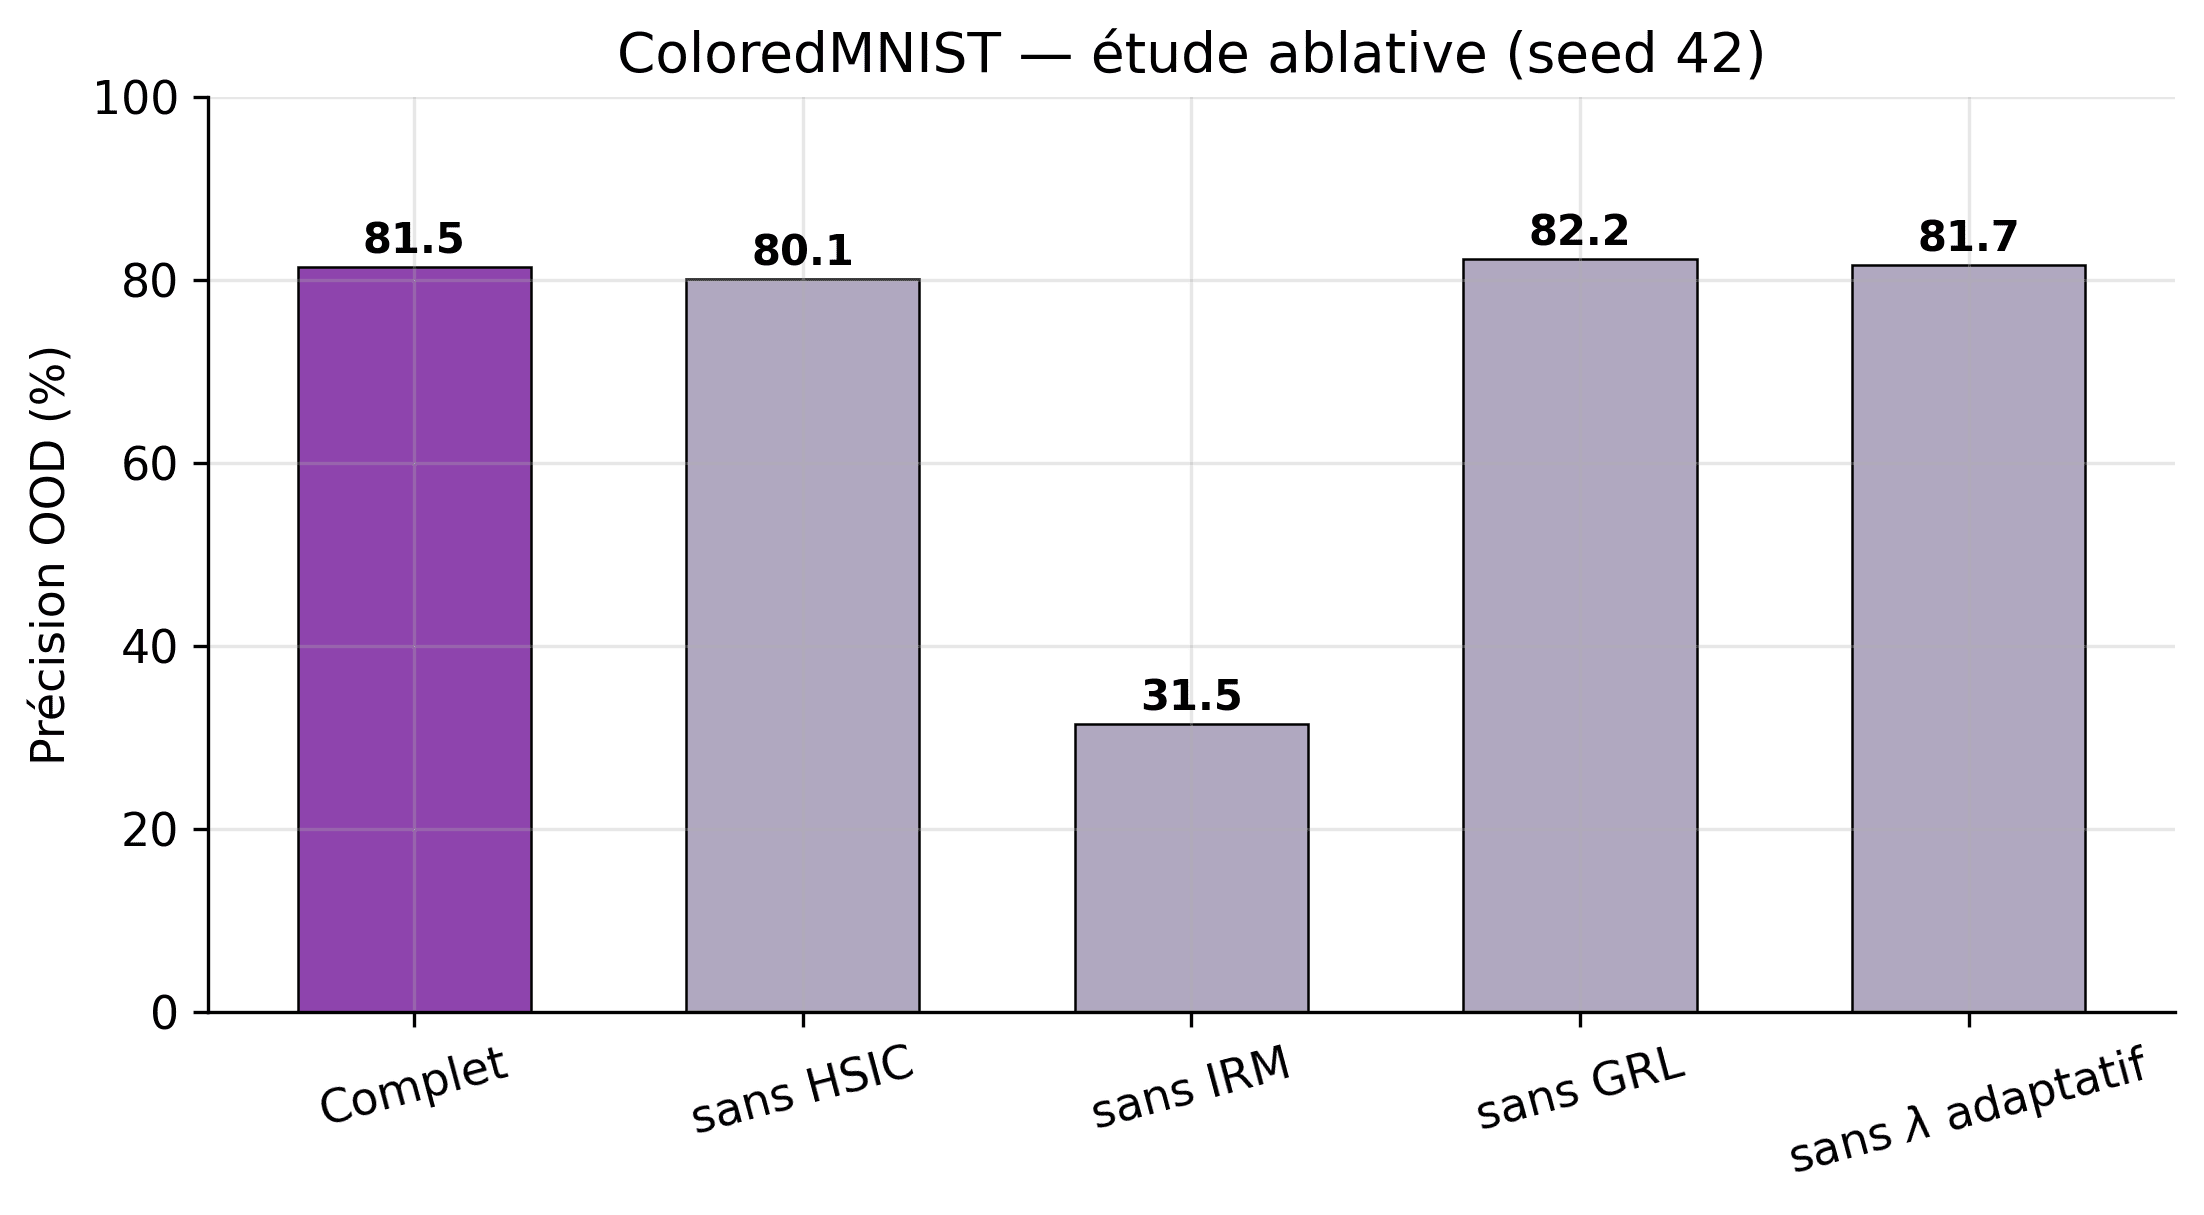
Étude ablative : sans la pénalité IRM, la précision chute à 31,6 %. Résultat négatif assumé : le probing linéaire montre que l'indépendance statistique ne garantit pas le démêlage sémantique ; la robustesse vient de l'invariance imposée au prédicteur.
Les limites
Sur la dérive diluée, la plus proche d'un cas réel, le détecteur se dégrade nettement (score F1 de 0,29, alarme avec trois fenêtres de retard). Les résultats PACS reposent sur une seule graine aléatoire, faute de budget de calcul. Les deux bancs d'essai sont des images : une évaluation sur un vrai flux de production, avec plusieurs dérives successives, reste à faire.