
Quand les données changent : pourquoi les modèles d'IA échouent, et comment les réparer
“Un bon modèle ne doit pas seulement être précis : il doit le rester quand le monde change.”
Un modèle d'intelligence artificielle apprend à partir d'exemples. Sans qu'on le lui dise, il fait une hypothèse très forte : les données qu'il rencontrera plus tard ressembleront à celles qu'il a vues pendant son entraînement.
Dans la réalité, cette hypothèse ne tient presque jamais longtemps. Une caméra est remplacée, une population d'utilisateurs évolue, des habitudes changent. Les données « dérivent », et un modèle qui affichait d'excellents scores en laboratoire peut voir ses performances s'effondrer, souvent sans que personne ne s'en aperçoive. C'est ce qu'on appelle la dérive des données, ou data drift. C'est le sujet de mon mémoire de Master recherche à l'Université de Dschang.
Deux façons dont les données changent
La première, la plus courante, est le covariate shift : les données d'entrée changent, mais la règle reste la même. Des photos plus sombres, un nouveau capteur, un autre format d'image. Un chat reste un chat, mais le modèle ne le reconnaît plus aussi bien.
La seconde, plus traîtresse, est le concept drift : c'est la relation entre les données et la réponse attendue qui change. Ce qui permettait hier de prédire correctement ne le permet plus aujourd'hui.
Un exemple qui piège les modèles
Pour étudier ce problème, les chercheurs utilisent des jeux de données construits exprès pour tendre un piège. Dans ColoredMNIST, on montre au modèle des chiffres manuscrits colorés. Pendant l'entraînement, la couleur est très corrélée à la bonne réponse, dans 90 % et 80 % des cas. Au moment du test, cette corrélation s'inverse.
Un modèle « paresseux » apprend donc la couleur, qui est plus facile à repérer que la forme du chiffre. Le jour du test, il se trompe massivement. L'entraînement classique (ERM) n'atteint que 32,7 % de bonnes réponses sur ces données de test : moins bien qu'en répondant au hasard. Le modèle n'est pas « mauvais » : il a appris la mauvaise chose.
L'idée : d'abord résister, ensuite réparer
L'architecture que j'ai conçue, RobustAI-Drift, traite le problème en deux temps.
Pendant l'entraînement, le modèle apprend à résister. Il sépare ce qui cause vraiment la réponse (la forme du chiffre) de ce qui n'est qu'un contexte (la couleur), et il est contraint de donner les mêmes réponses dans des environnements différents. C'est le principe de l'invariance : ce qui reste vrai partout a plus de chances d'être la vraie règle.
Une fois le modèle déployé, il faut réparer. Un détecteur surveille en continu les données qui arrivent, repère quand elles s'écartent de celles de l'entraînement, puis identifie le type de dérive. La réponse n'est pas la même dans les deux cas : un simple réalignement suffit pour un covariate shift, alors qu'un concept drift demande de réentraîner une partie du modèle sur les nouvelles données. Et la dérive détectée devient elle-même un nouvel exemple d'environnement pour la suite de l'entraînement : la boucle se referme.
Ce que montrent les expériences
Ces résultats sont rapportés dans un article en cours d'évaluation dans la revue Pattern Recognition.
Sur ColoredMNIST, RobustAI-Drift atteint 81,5 % de bonnes réponses sur les données de test, contre 32,7 % pour l'entraînement classique et 80,7 % pour l'invariance seule. Sur PACS, un jeu d'images de quatre styles différents (photo, peinture, dessin animé, croquis), la précision passe de 73,0 % à 79,8 %, et surtout elle devient beaucoup plus stable : sur les croquis, le cas le plus difficile, elle passe de 48,3 % à 67,8 %.
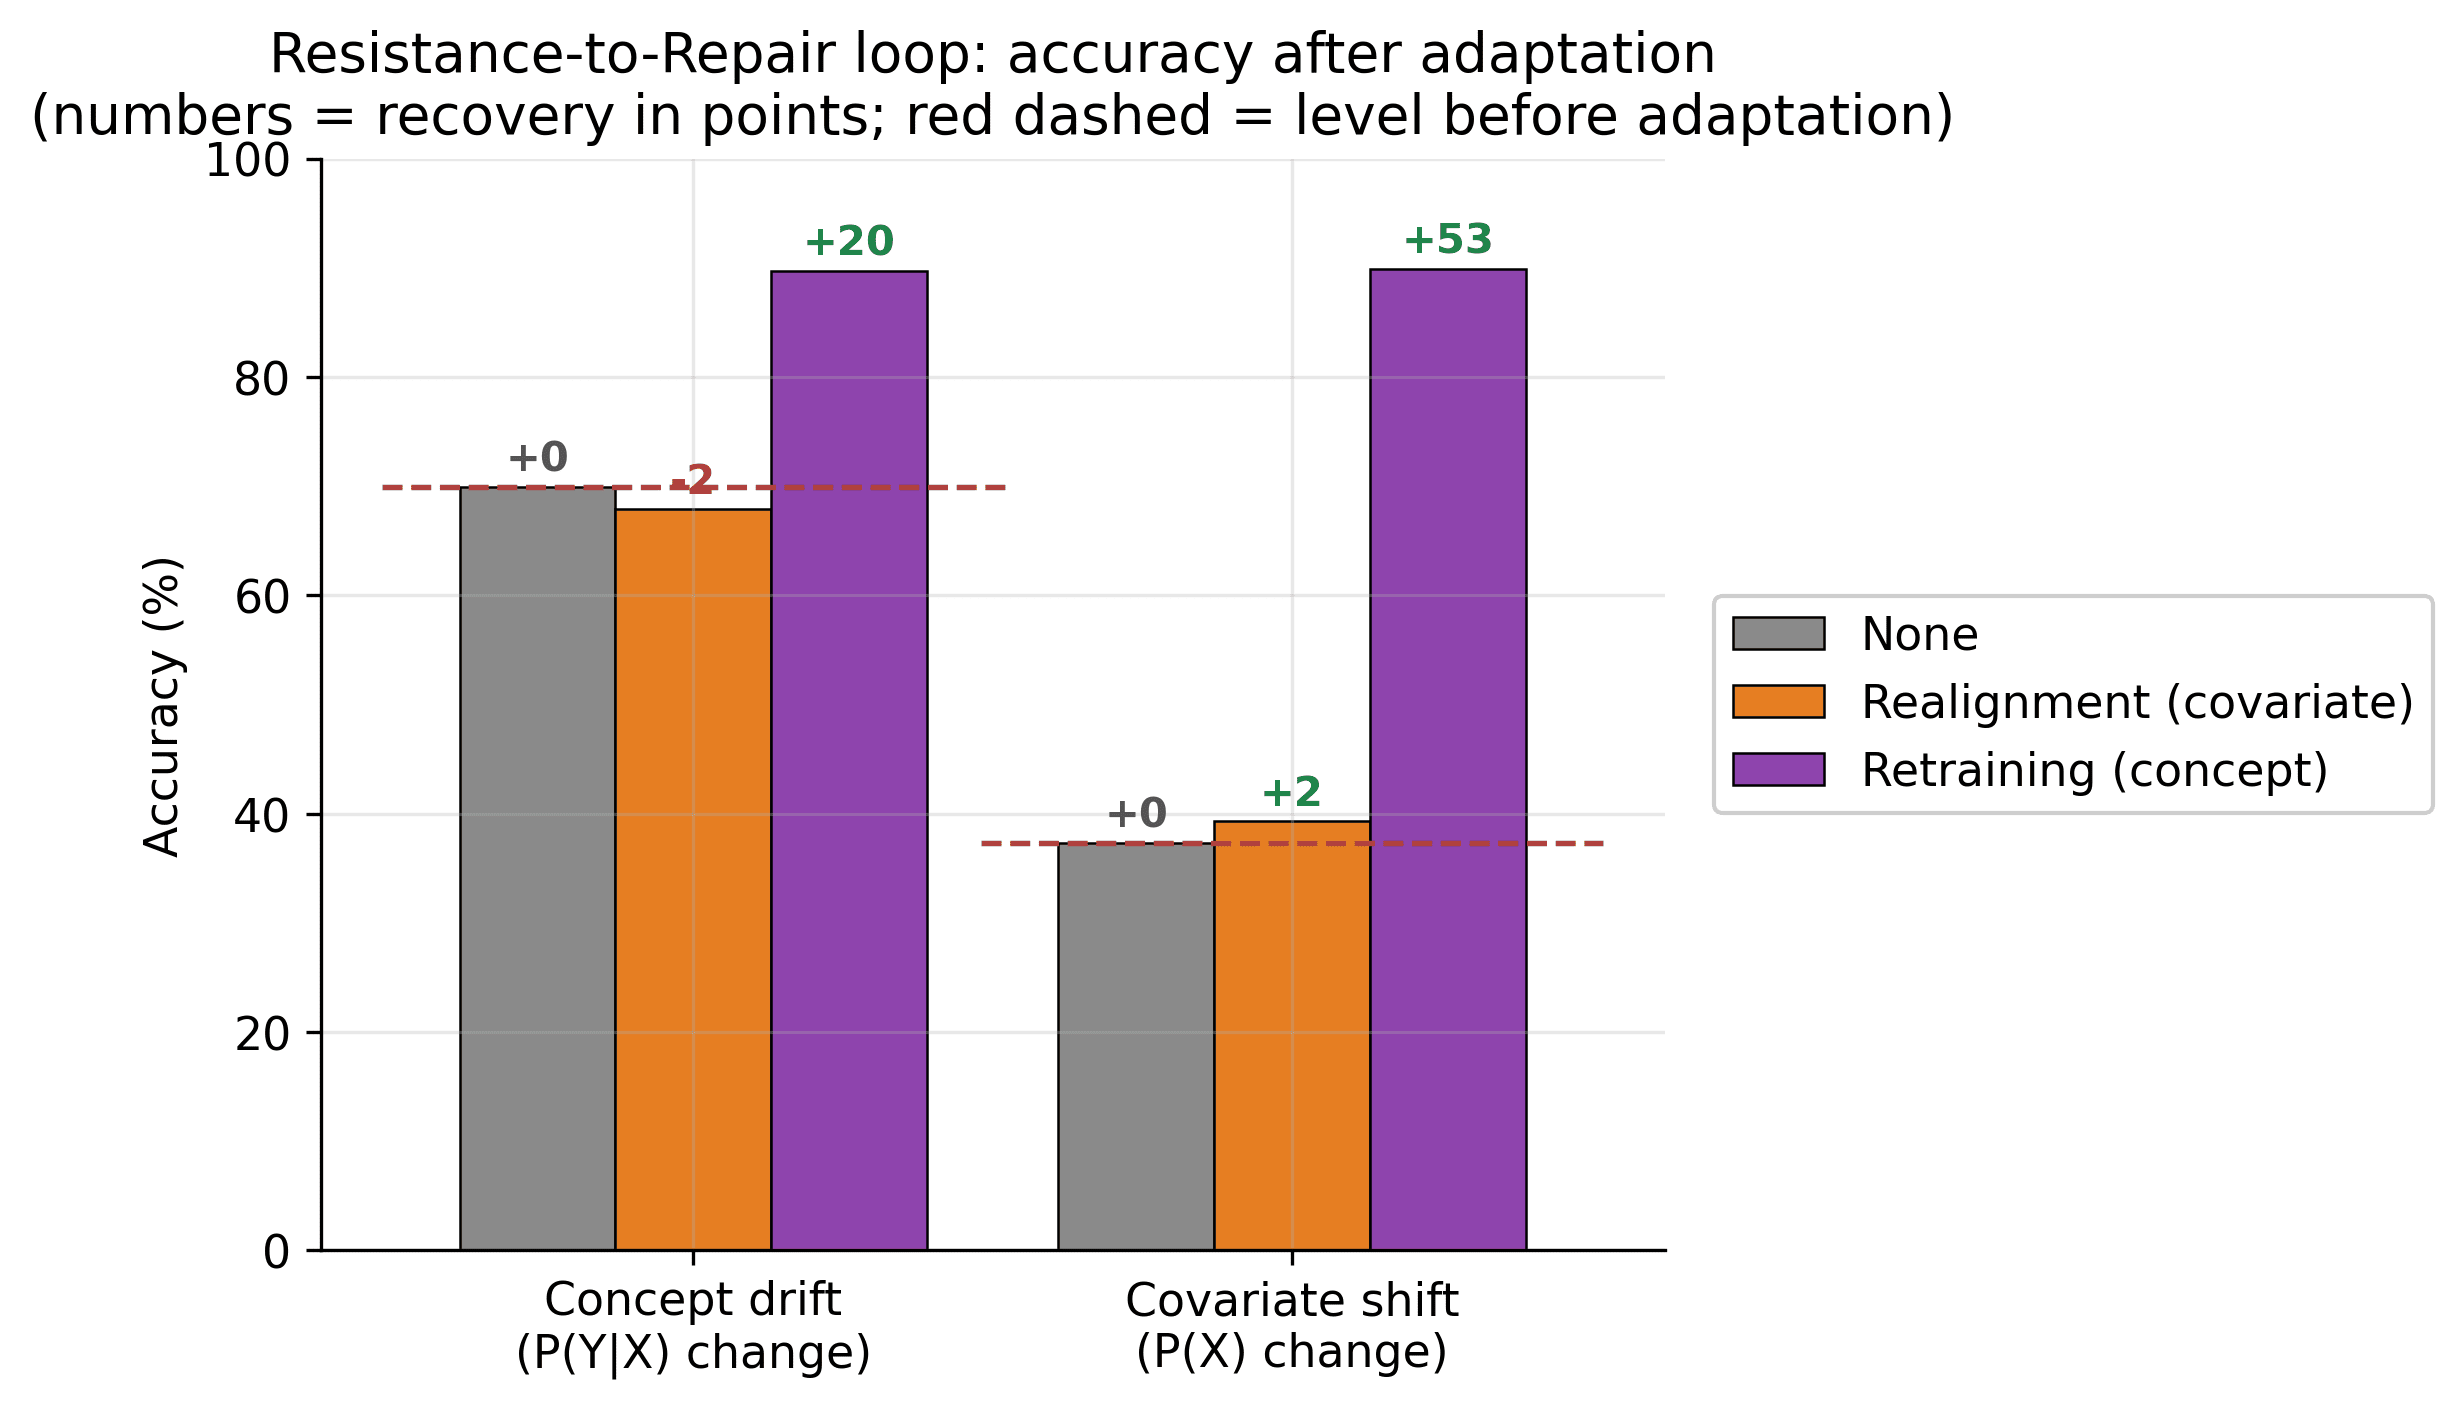
La boucle de réparation fonctionne aussi : après un concept drift, la précision remonte de 69,9 % à 89,7 % ; après un covariate shift, de 37,3 % à 89,9 %. À l'inverse, une réponse mal choisie échoue. C'est la preuve qu'il faut d'abord comprendre quel type de dérive on observe avant d'agir.
Ce qui ne marche pas encore
Un travail de recherche honnête montre aussi ses limites. Quand la dérive est diluée, progressive, c'est-à-dire la situation la plus proche d'un cas réel, le détecteur devient beaucoup moins fiable. Les expériences portent sur des images, et il reste à évaluer l'approche sur un vrai flux de données en production, avec plusieurs dérives successives.
Les expériences ont aussi produit un résultat inattendu, que j'ai choisi d'assumer : séparer statistiquement la forme et la couleur ne garantit pas que le modèle ait vraiment « compris » la différence. La robustesse vient surtout de la contrainte d'invariance imposée à la prédiction.
Ce qu'il faut retenir
Si vous déployez un modèle d'IA, trois réflexes valent la peine d'être pris. Évaluez-le sur des données différentes de celles de l'entraînement, et regardez la stabilité de ses résultats plutôt que son meilleur score. Surveillez-le une fois en production : un modèle qui se dégrade en silence est plus dangereux qu'un modèle qui prévient. Et avant de réagir à une dérive, identifiez sa nature : la bonne réponse en dépend.
Le détail du projet, des données et du protocole se trouve sur la page RobustAI-Drift de ce portfolio. Si ce sujet vous intéresse, pour un projet ou une collaboration de recherche, écrivez-moi.